Как мы проверяем качество генерации
Что мы считаем ошибкой в задании, как вопрос проверяется до того, как его увидит учитель, и откуда берутся цифры в нашем публичном отчёте о качестве.
 Команда aiTalim
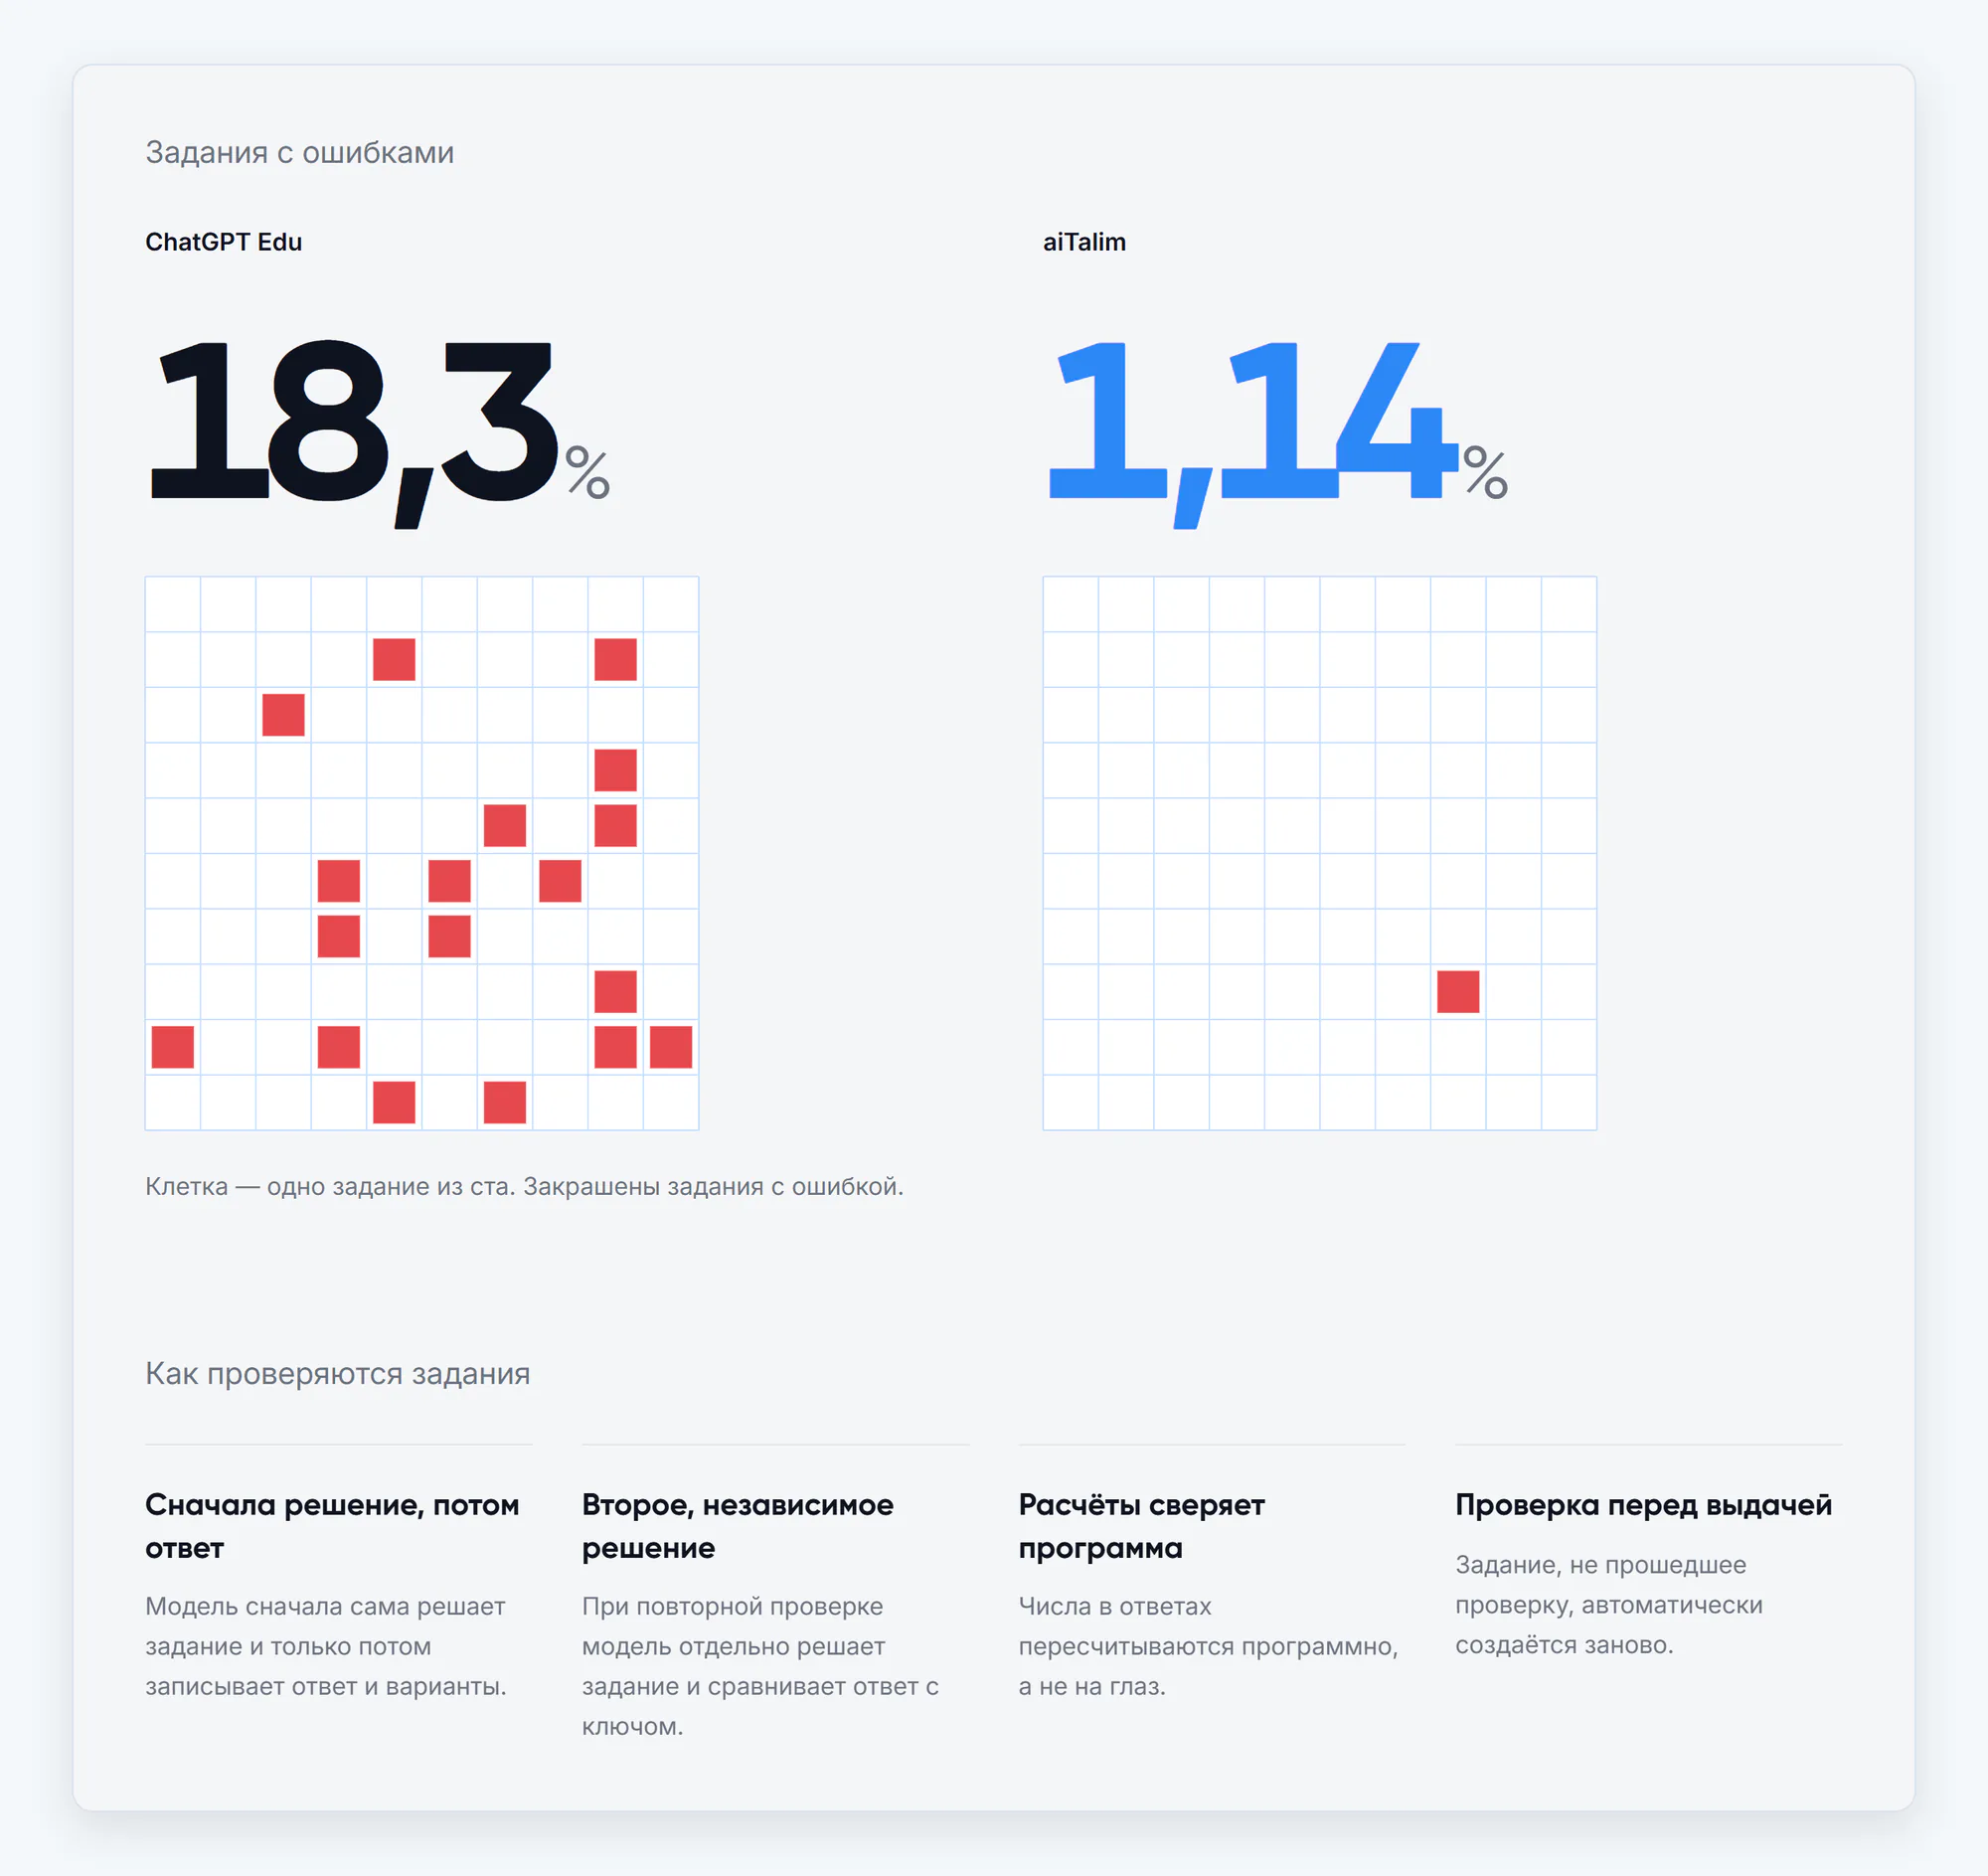
ИИ ошибается. Мы не обещаем, что ошибок не будет, но меряем, как часто они доходят до учителя, и публикуем результат вместе с методикой. По последнему срезу, от 13 октября 2026 года, подтверждённые ошибки нашлись в 16 заданиях из 1405 — это 1,14%. Ниже — что стоит за этой цифрой и где она пока ничего не доказывает.
Что мы считаем ошибкой
Ошибка — это неверный факт или неверный ключ, неполный список правильных ответов, неоднозначные варианты, недостающие условия. Простая проверка: если ученик не может решить задание по тем данным, которые ему дали, или правильный ответ не соответствует условию, задание бракованное.
В отчёте такие случаи делятся на два вида: фактические ошибки и существенные методические дефекты. Их сумма и есть «подтверждённые дефекты». Отдельно считаются две вещи, которые в эту сумму не входят:
- редакторские замечания — небольшая правка текста, когда само задание решается верно;
- спорные случаи, где нельзя однозначно сказать, ошибка это или нет.
В последнем срезе редакторских замечаний 63, спорных случаев 18.
Что происходит с вопросом до того, как вы его увидите
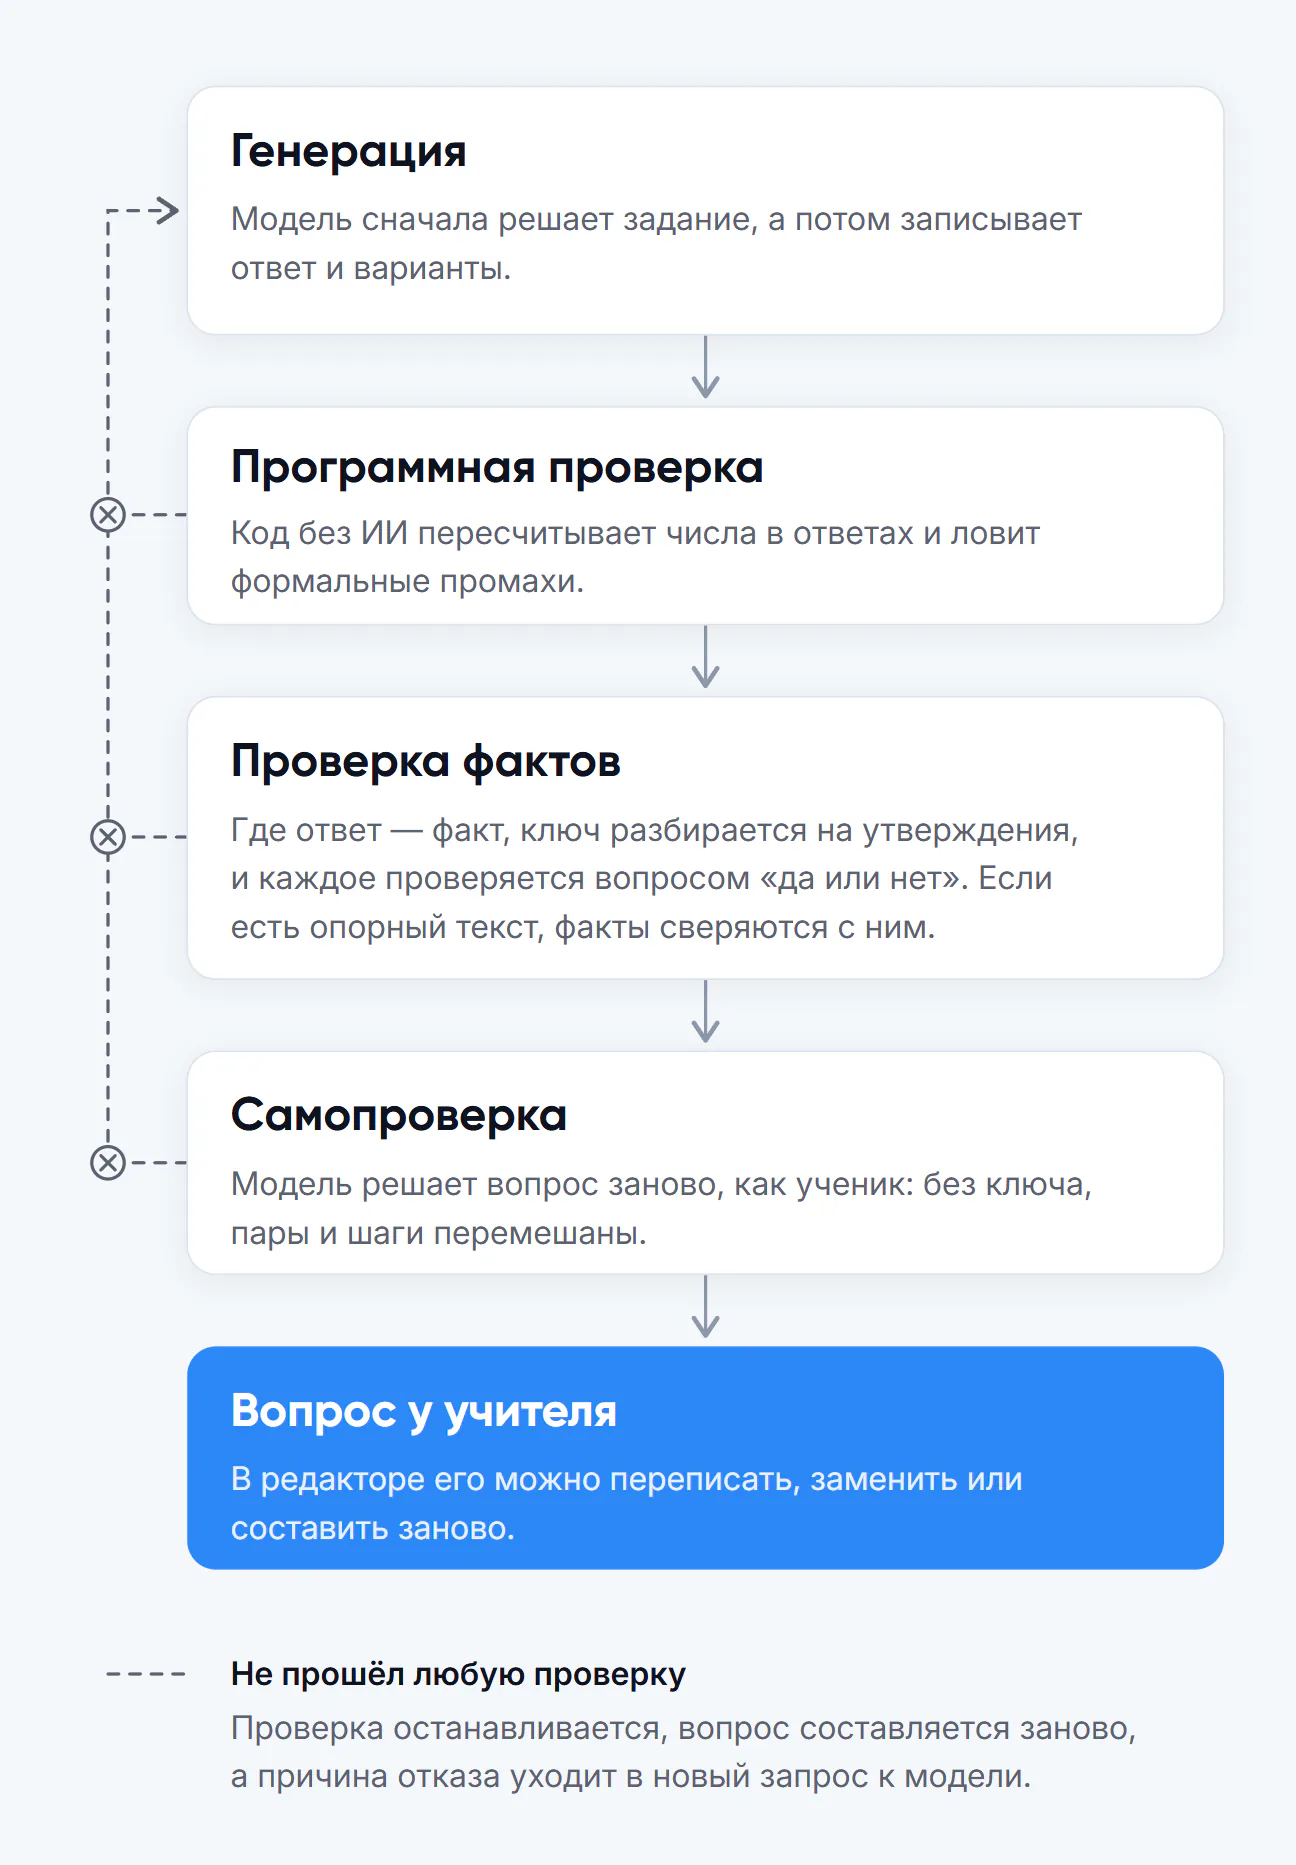
Ещё при генерации модель сначала решает задание и только потом записывает ответ и варианты. Дальше каждый вопрос теста проходит несколько проверок подряд. Первая же найденная проблема останавливает проверку, и вопрос составляется заново, а причина отказа уходит в новый запрос к модели.
Программная проверка. Сначала код, без всякого ИИ. Он пересчитывает числа в ответах: если в условии линейное уравнение, код сам находит корень и сверяет его с ключом. Ловятся и формальные промахи. Например, если в задании на хронологию к каждому событию уже приписан год, порядок виден без всяких знаний — такой вопрос тоже уходит в брак.
Проверка фактов. Для предметов, где ответ — факт, а не вычисление (история, биология, география, литература), ключ разбирается на отдельные утверждения: этот вариант верен, эта пара в сопоставлении соответствует, это событие идёт раньше того. Каждое утверждение проверяется отдельным вопросом «да или нет». Когда мы пробовали спрашивать целиком «ключ верен?», модель путалась чаще.
Если у задания есть опорный текст, факты сверяются с ним, а не с памятью модели. В литературе цитата и детали, приписанные фрагменту, должны находиться именно в этом фрагменте. В основах права ответ сверяется с текстом официальных статей. Поэтому мы и советуем выбирать учебник при создании материала: тогда вопросы опираются на те же страницы, что у ваших учеников.
Самопроверка. Последний шаг — модель получает готовый вопрос так, как его увидит ученик: без ключа, а пары в сопоставлении и шаги последовательности перемешаны. Она решает его заново, и её ответ сравнивается с ключом. Разошлись — вопрос составляется заново. Модель может и сама сказать, что в условии чего-то не хватает, это тоже причина для повтора. Этот шаг ловит то, чего не видит код: два верных ответа там, где отмечен один, или порядок, который на самом деле не единственный.
Важная деталь: замер качества идёт через тот же конвейер, что и обычная генерация у учителя. Иначе мы мерили бы не то, что вы получаете.
Как устроен замер
Мы берём набор заданий по предметам и проверяем каждое выданное. Проверочные ИИ-агенты сначала фиксируют собственное решение и только потом сравнивают его с ключом. Подтверждённые дефекты проходят вторую проверку. В последних замерах казахского языка, казахской литературы и истории Казахстана ключи, образцы ответов и источники учителя раскрывались проверяющим только после того, как их решения были зафиксированы. В более ранних проверках проверяющим могли быть видны допустимые варианты ответов и критерии эссе, и в отчёте это оговорено.
Знаменатель — задания, которые учитель действительно получил бы. Из 1570 запланированных выдано 1405, а 165 до выдачи не дошли. Эти 165 в долю ошибок не входят и показаны отдельной строкой, как показатель доступности генерации. Делить ошибки на запланированное было бы нечестно в нашу пользу.
Каждый предмет в таблице представлен своим последним завершённым замером. Даты и объём проверок у предметов разные, одни и те же проверки дважды не суммируются.
Что показывают цифры
Те 1405 заданий, с которых мы начали, — это 17 предметов, 5–11 классы и три языка: казахский, русский и английский.
Для сравнения у нас есть ориентир: та же модель GPT-6 Luna с теми же настройками, но вызванная через API, без учебного контекста и проверок платформы. Там подтверждённых дефектов 110 на 600 заданий, 18,33%. На главной этот ориентир подписан как ChatGPT Edu. Сравнение непарное: у двух замеров разные даты, разные наборы заданий и условия генерации. Поэтому это ориентир, а не точное измерение того, насколько мы лучше.
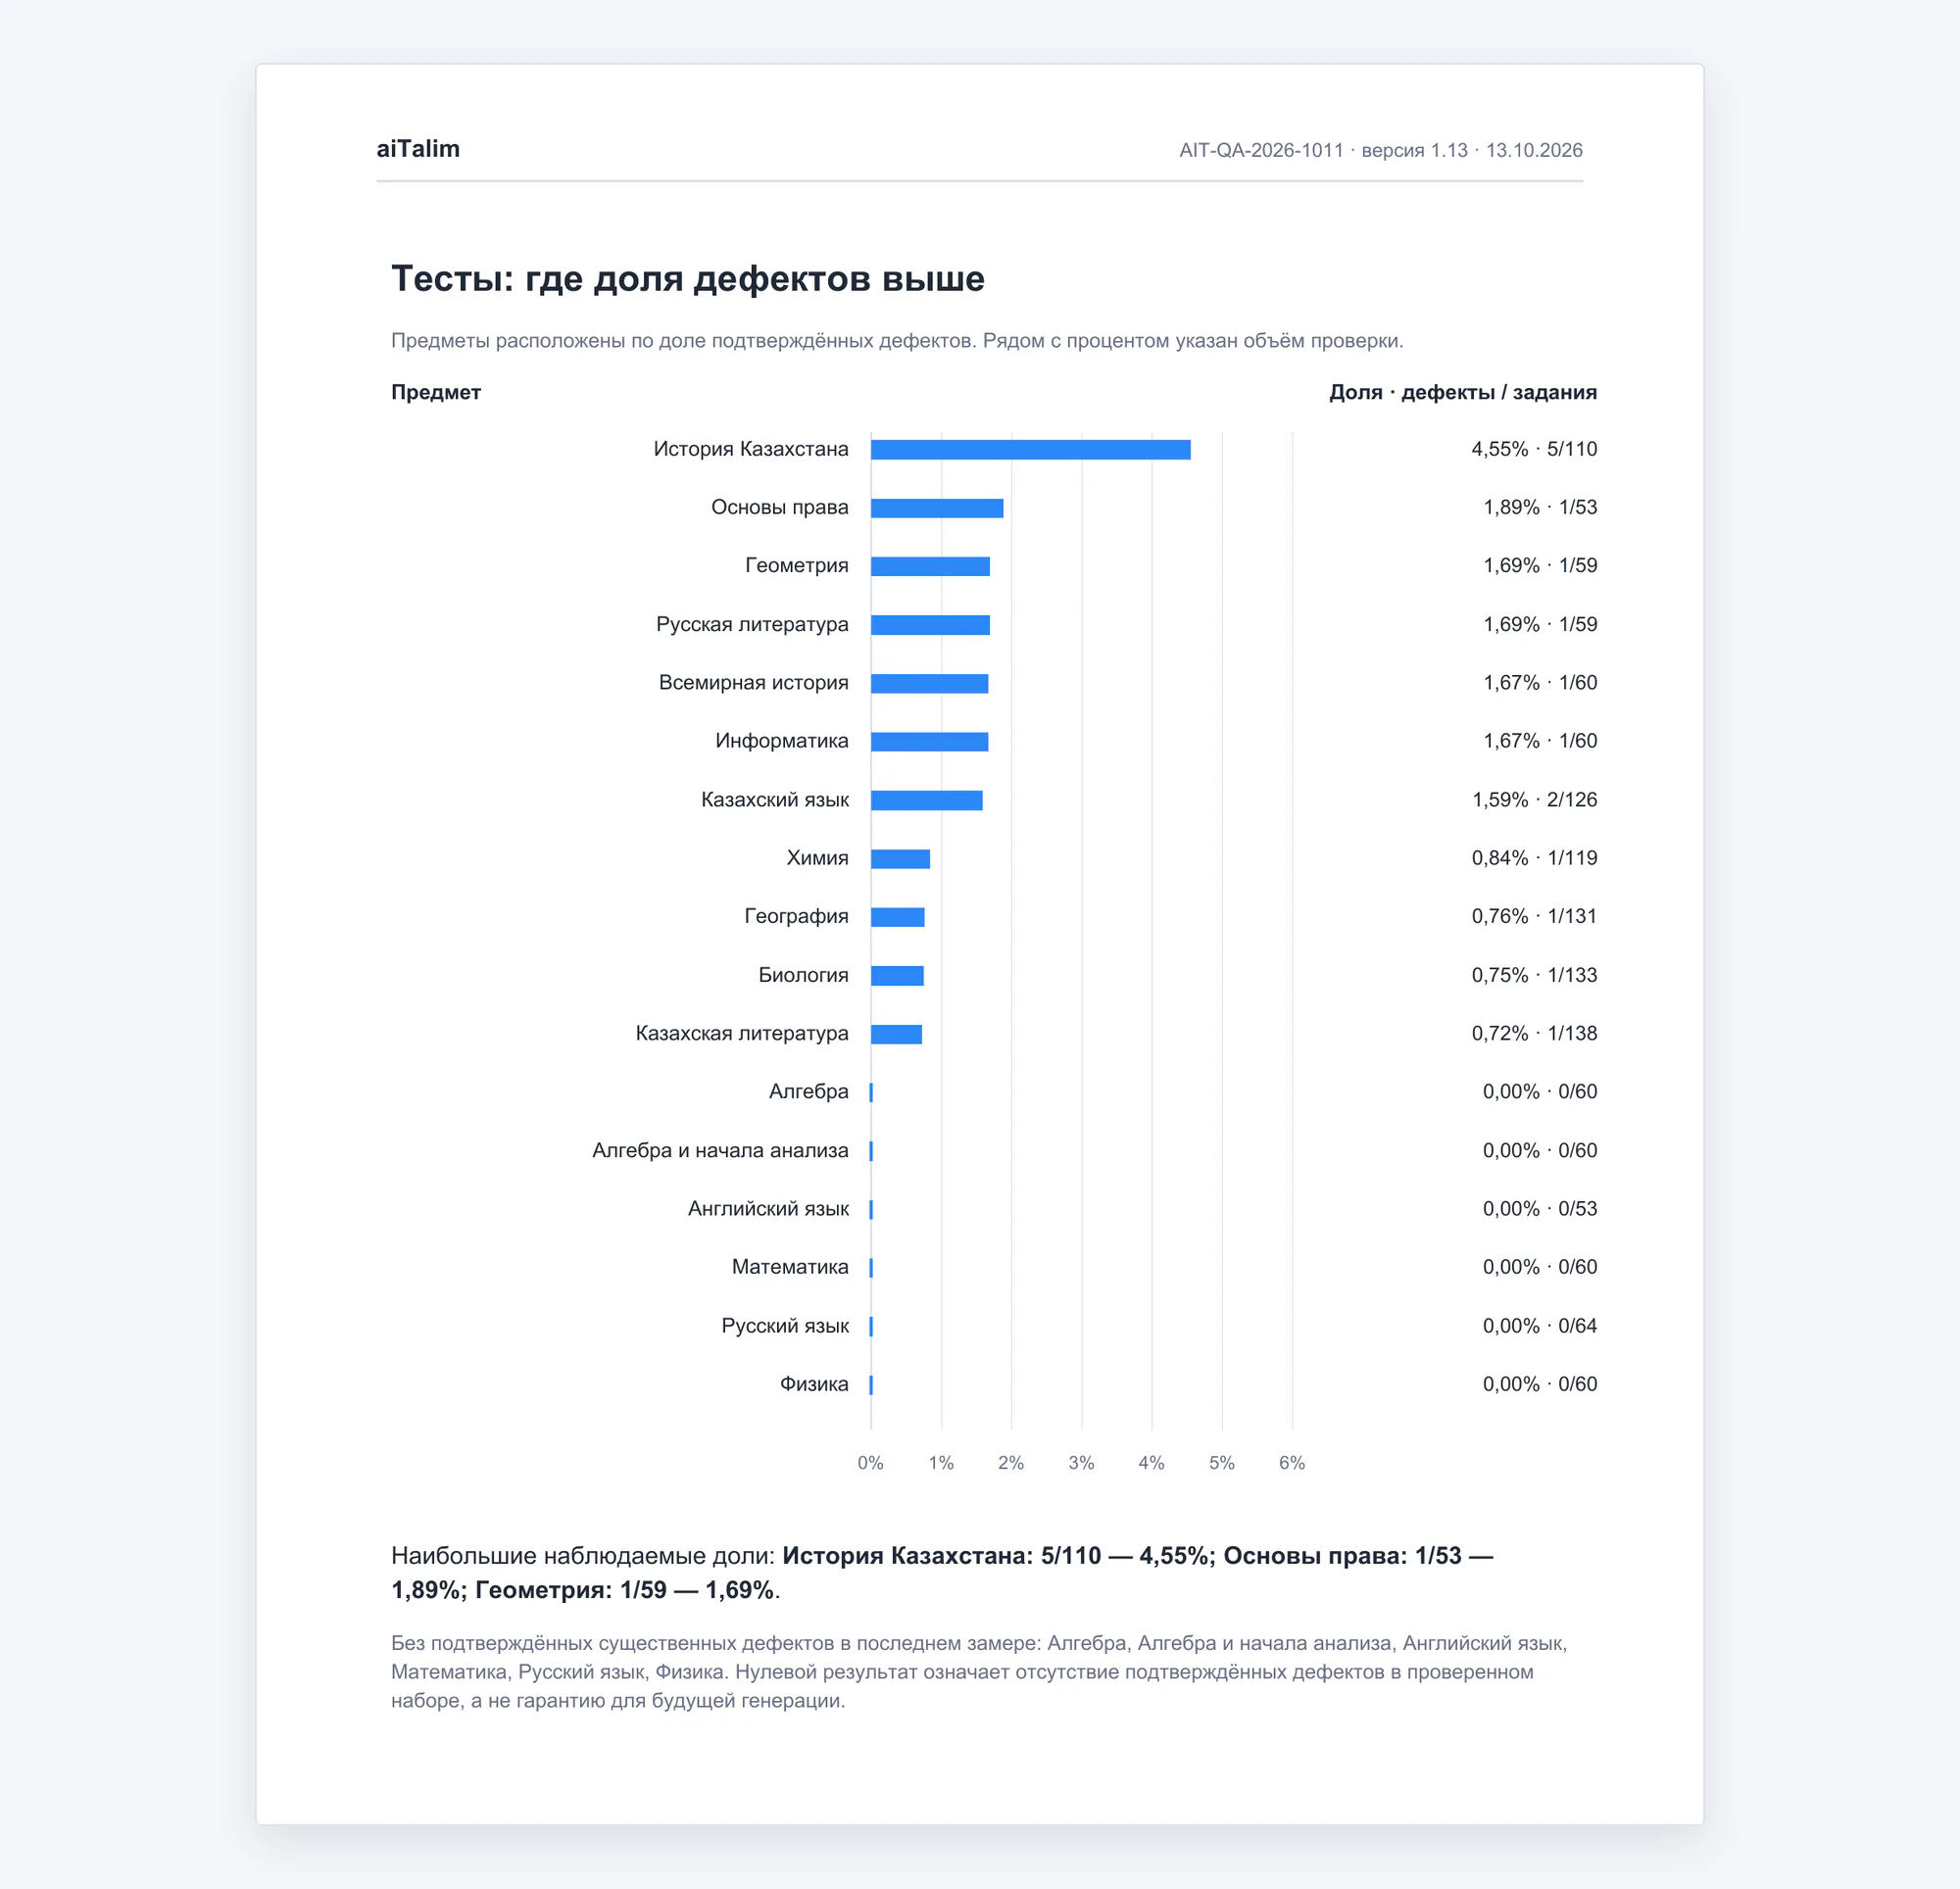
Хуже всего у нас сейчас история Казахстана: 5 дефектов на 110 заданий, 4,55%. Дальше основы права (1 из 53, 1,89%) и геометрия (1 из 59, 1,69%). В алгебре, алгебре и началах анализа, английском языке, математике, русском языке и физике подтверждённых дефектов в последнем замере нет. Это значит только, что их не нашлось в проверенном наборе, а не что их не будет завтра.
Задания PISA считаются отдельно и в общую долю не входят: 96 заданий, 1 подтверждённый дефект, 1,04%, ещё одно редакторское замечание и 3 спорных случая. Пока проверены только четыре предметных контекста и 6, 8, 10 и 11 классы; начальная школа и PIRLS требуют отдельной проверки.
Где цифры ничего не доказывают
- Это диагностический набор заданий, а не случайная выборка из всего, что генерируют учителя.
- Проверяли ИИ-агенты, а не независимая комиссия учителей. Это внутренний контроль.
- Сложность заданий и соответствие программе пока не подтверждены отдельной проверкой.
- СОР и СОЧ в отчёт пока не входят.
- Часть предметов дорабатывалась после замера, и эти доработки ещё ждут новой проверки.
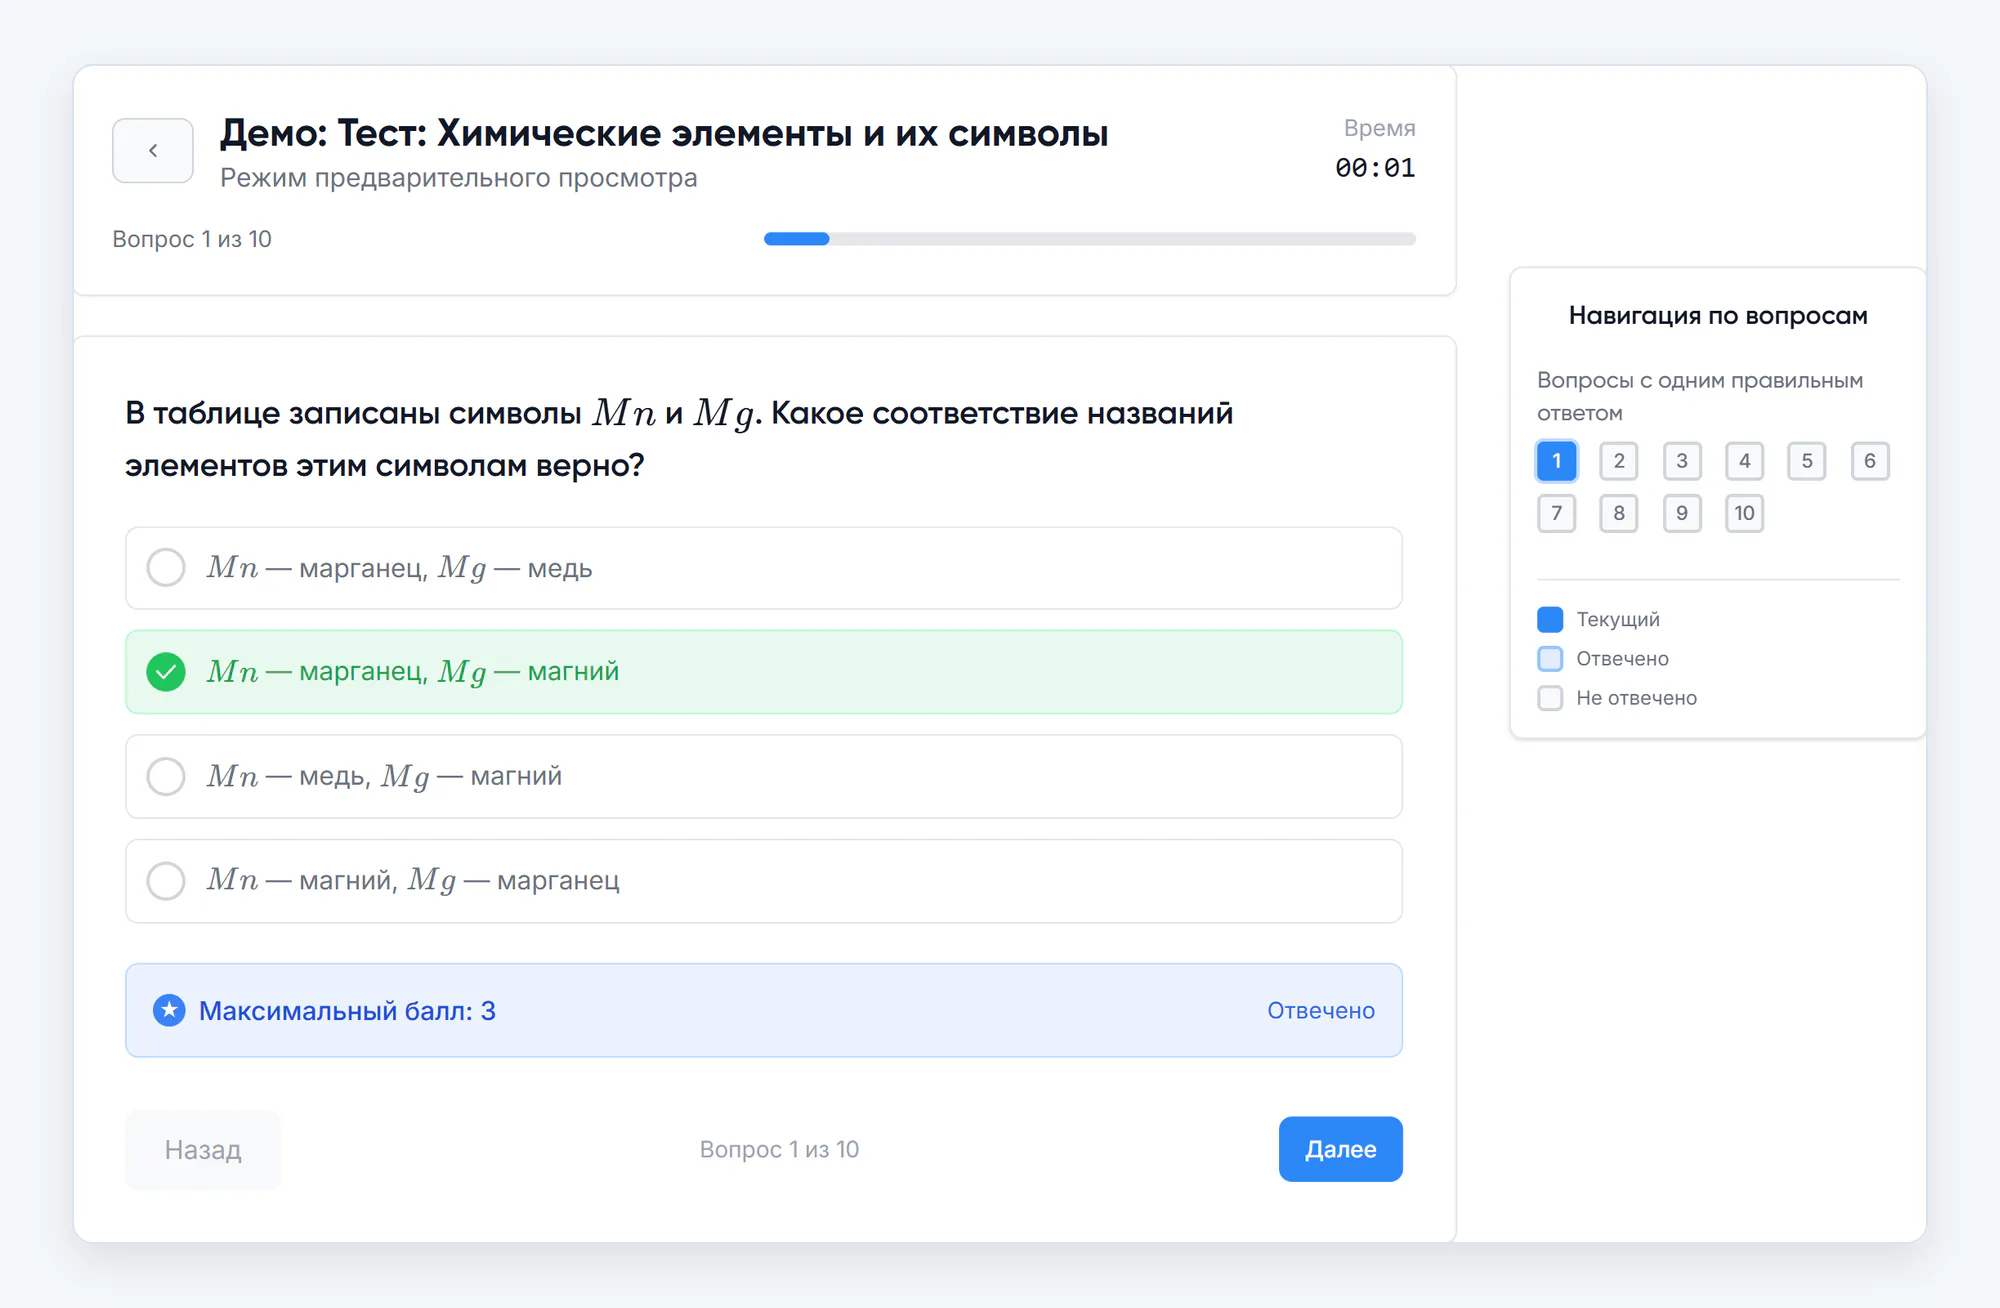
Именно поэтому перед выдачей мы советуем пройти тест самому в демо-режиме. Примерно одно задание из ста с ошибкой — это мало, но не ноль.
Зачем публиковать
Фраза «качество высокое» вам ничего не даёт. Полезнее знать, сколько ошибок, каких и в каких предметах: тогда понятно, где перепроверять внимательнее. А без методики и голая цифра немного стоит — непонятно, что считали и что выбросили. Поэтому отчёт публичный, с таблицами по каждому предмету, определениями и ограничениями.
Нам самим он нужен не меньше. Таблица по предметам показывает, где работать дальше. Цель, которую мы себе поставили, — меньше 2% подтверждённых дефектов по каждому предмету, а не только в среднем. История Казахстана пока до неё не дотягивает.
Сводка — в разделе «Качество» на главной. Полные таблицы, методика и все оговорки — в отчёте о качестве (PDF). Новые замеры будут заменять строки старых, и мы будем обновлять отчёт по мере проверок.